Godzinna przerwa w pracy czujnika rzadko jest prawdziwym problemem. Prawdziwy problem to półtorej godziny odczytów, które po cichu znikają, gdy urządzenie wraca do sieci. Takiej luki nikt nie zauważa - aż do momentu, gdy ktoś zakwestionuje raport dla urzędu albo alarm się nie włączy, bo model, który go wyzwala, uczył się na niepełnej historii.
W monitoringu środowiska to codzienność. Brak zasięgu GSM, tryb uśpienia oszczędzający baterię, stacje w miejscach ze słabym pokryciem - to nie są wyjątki, tylko normalne warunki pracy. Każdy system pobierania danych, który zakłada, że urządzenie jest zawsze dostępne, będzie gubić dane. I będzie je gubić po cichu.
Rozwiązaniem nie jest droższy sprzęt, tylko inne podejście do czasu: system nie powinien pytać „co się wydarzyło w ostatniej godzinie?”, ale „jaki jest ostatni pomiar, który faktycznie zapisałem?”. Poniżej wyjaśniam, dlaczego proste podejście zawodzi i jak synchronizacja oparta na znaczniku ostatniego zapisu (watermark) zamyka tę lukę.
Tryb „zapisz i wyślij później” to norma
W idealnym świecie urządzenia IoT są stale połączone i wysyłają dane na bieżąco przez MQTT albo WebSockety. W prawdziwym świecie - zwłaszcza w monitoringu przemysłowym i środowiskowym - łączność jest luksusem, a nie gwarancją.
Czy to brak zasięgu GSM na wiejskiej stacji hydrologicznej, czy cykl uśpienia oszczędzający baterię - urządzenia bardzo często działają w trybie „Store and Forward”: zapisują pomiary w pamięci i wysyłają je hurtem, gdy łączność wraca.
Jeśli integrujesz takie urządzenia przez zwykłe API REST, masz poważny problem z synchronizacją. Jeżeli pobieranie danych opiera się u Ciebie na „bieżącym czasie”, już teraz tracisz dane.
Pułapka: odpytywanie „za ostatnią godzinę”
Najczęstszy błąd przy pobieraniu danych z IoT to powiązanie okna pobierania z zegarem serwera. Wyobraź sobie zadanie cron, które co godzinę pobiera dane „z ostatnich 60 minut”.
GET /measurements?from=now-1h&to=nowScenariusz: o 10:00 urządzenie traci zasięg GSM. O 12:00 łapie sygnał i wysyła zaległe dane z okresu 10:00-12:00. O 12:05 uruchamia się cron i prosi o dane z przedziału 11:05-12:05.
Dane z 10:00-11:05 bezpiecznie trafiły do chmury producenta, ale Twój system nigdy o nie nie poprosił - wypadły poza przesuwające się okno. Takie luki zwykle są niewidoczne i wychodzą na jaw dopiero po miesiącach, przy analizie historycznej. A wtedy alarmy o wyciekach się nie włączają, modele przewidujące awarie dostają niepełne dane, a raporty dla urzędów tracą wartość dowodową. W IoT dane, które giną po cichu, to pieniądze, które uciekają niezauważone.
Rozwiązanie: znacznik ostatniego zapisu
Żeby dane były kompletne, trzeba oddzielić „czas pobrania” od „czasu zdarzenia”. Strategia znacznika (watermark, nazywana też synchronizacją kursorową) opiera się na stanie bazy danych, a nie na zegarze. Zamiast pytać „co się wydarzyło w ostatniej godzinie?”, system pyta: „jaki jest znacznik czasu ostatniego rekordu, który udało mi się zapisać?”.
Logika pobierania zmienia się z przesuwającego się okna na kursor zakotwiczony w ostatnim zapisie:
const watermark = await db.measurements.findLast().timestamp;

GET /measurements?from=${watermark}
Skoro punktem zaczepienia jest ostatni znany pomiar, system sam uzupełnia wszystkie luki w historii. Jeśli urządzenie było offline przez trzy dni, następne zapytanie automatycznie obejmie te trzy dni - bez żadnej ręcznej interwencji.
Jak to wygląda w kodzie
W Silentbits realizuję to za pomocą harmonogramu zadań - to jeden z kluczowych elementów systemów takich jak Wodowskaz. Poniżej uproszczona logika usługi pobierającej dane w Node.js:
async function syncStationData(stationId: string) {
  // 1. Pobierz "watermark" (czas ostatniej udanej synchronizacji)
  const lastRecord = await prisma.measurement.findFirst({
    where: { stationId },
    orderBy: { timestamp: 'desc' }
  });

  // Dla nowej stacji: ostatnie 24 h, w przeciwnym razie od watermarku
  const fromDate = lastRecord
    ? lastRecord.timestamp
    : subHours(new Date(), 24);

  // 2. Pobierz dane, zaczynając od watermarku
  const data = await api.fetchMeasurements({
    stationId,
    from: fromDate.toISOString()
  });

  if (data.length === 0) return; // System jest aktualny

  // 3. Zapisz dane i zaktualizuj stan
  await prisma.measurement.createMany({ data });
  console.log(`Zsynchronizowano ${data.length} rekordów. Luka zamknięta.`);
}
REST czy MQTT: szerszy kontekst
Uczciwie trzeba dodać, że ten wzorzec rozwiązuje konkretny problem: integracje typu PULL, czyli odpytywanie API REST. W nowoczesnych systemach IoT, w których masz wpływ na oprogramowanie urządzenia, lepiej sprawdzają się protokoły typu PUSH, takie jak MQTT czy CoAP. One same pilnują dostarczenia wiadomości (QoS - poziom gwarancji dostarczenia) na poziomie transportu, bez dodatkowej logiki synchronizacji.
W praktyce jednak często integruję sprzęt innych producentów - stacje meteorologiczne, starsze sterowniki PLC - w których jedynym dostępem do danych jest API REST producenta. W takich warunkach strategia znacznika to nie jedna z opcji, tylko branżowy standard niezawodności.
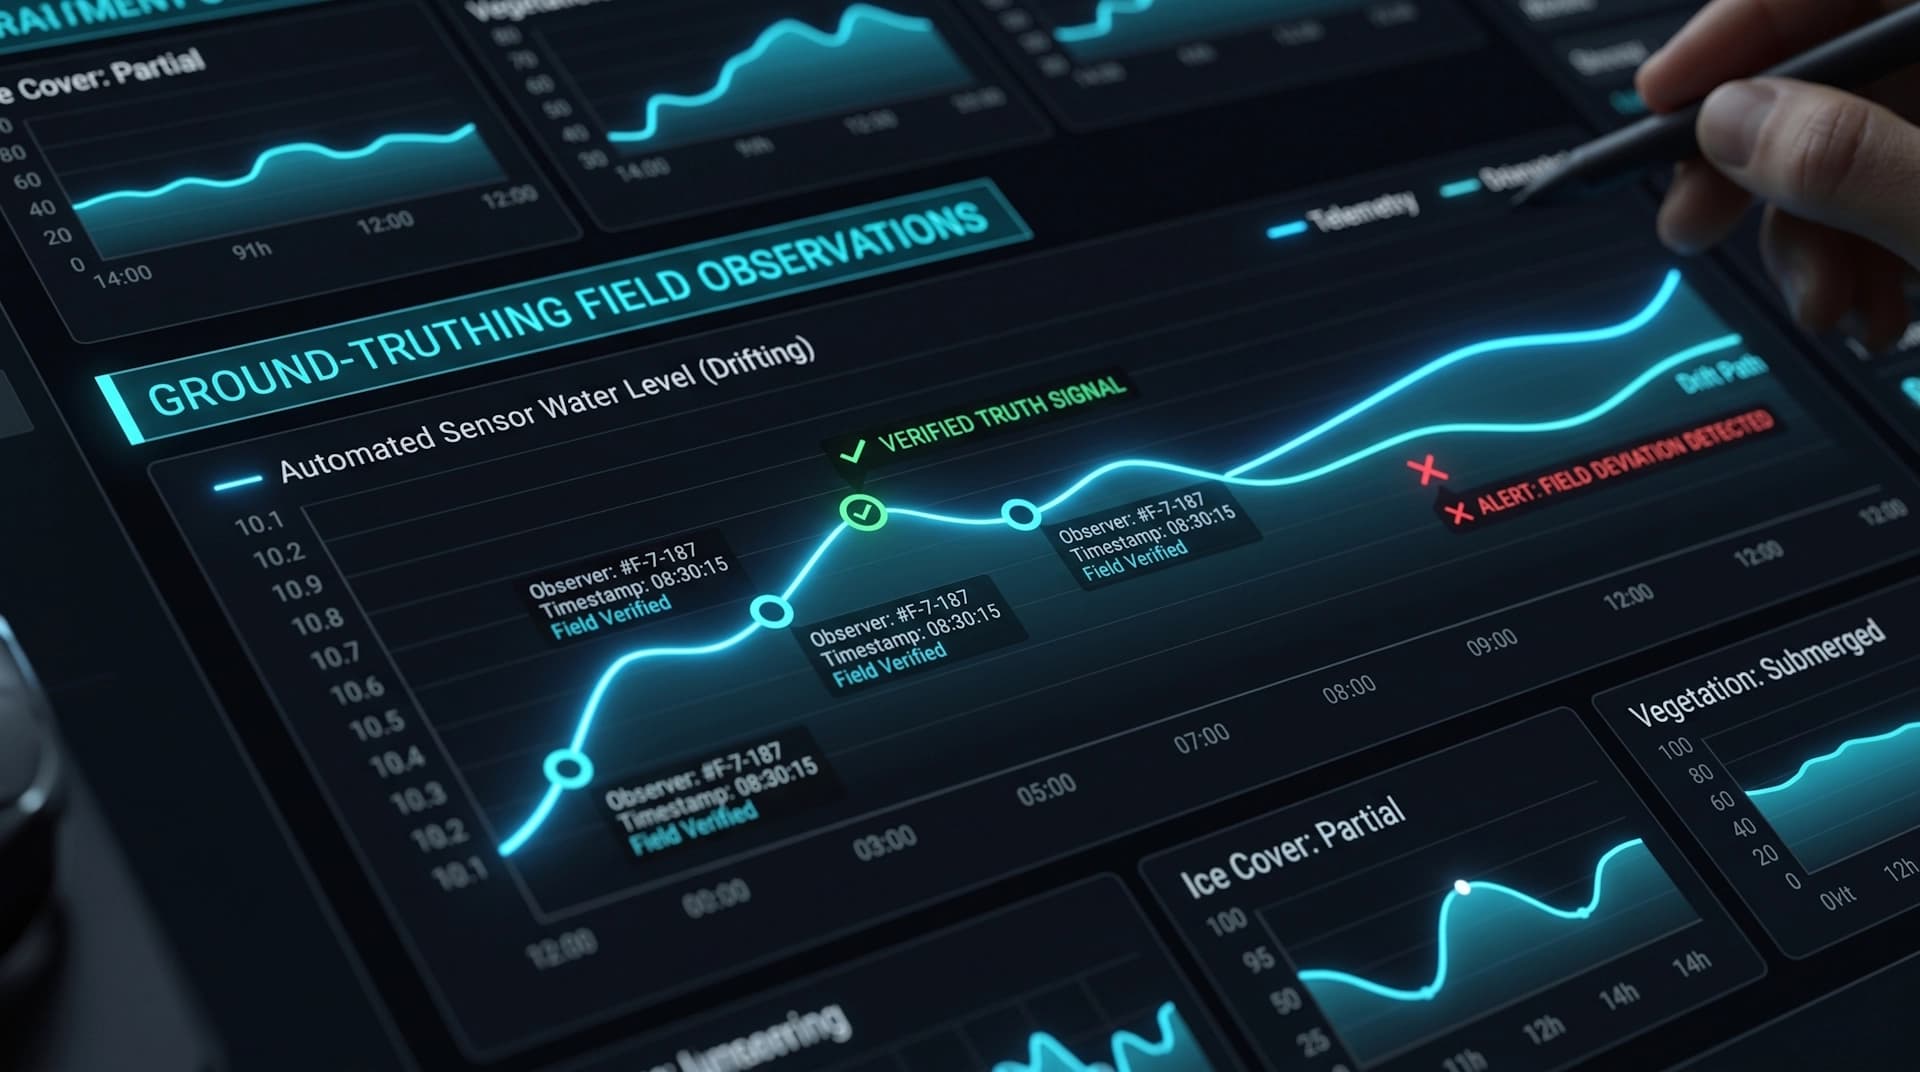
Wizualizacja danych jest tak dobra, jak mechanizm, który te dane dostarcza. Synchronizacja oparta na stanie bazy zamienia kruchy skrypt w system, który sam nadrabia zaległości po powrocie łączności. Pamiętaj jednak, że rekord, który dotarł w całości, wcale nie musi być poprawny. O tym, jak wychwycić czujnik, który nie milczy, tylko po cichu podaje złe wartości, piszę w artykule o weryfikacji pomiarów w terenie.